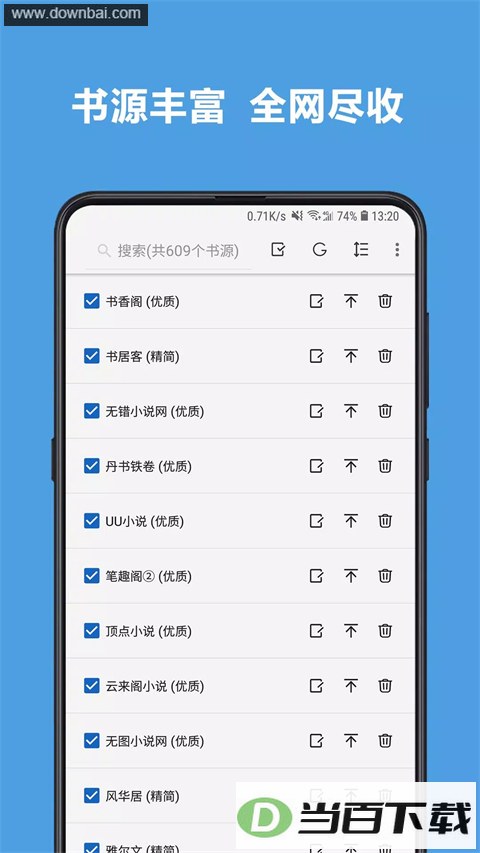
开源阅读这款工具的核心思路是让用户自己配置书源,它其实更接近一个浏览器,需要套用特定规则去解析各类网页后才能呈现内容。使用者能自行添加不同来源的书源,按照书名去搜索正版渠道再打开阅读,每个书源都附带免费的有声朗读,闭上眼也能听书。软件自带替换净化能力,界面干净没有广告,可长期免费使用。阅读界面、字体、颜色、背景、行距、简繁转换这些细节都能按个人习惯调整,翻页观感接近纸质书。
找书源这一环同样交给用户自己掌控,切换不同书源、套用不同规则,就能更准确地锁定想找的内容,上手门槛不高,实际用起来也顺手。
书源规则建立在HTML标记之上,class、id、tag这些属性是识别内容的基础。想动手写规则,得先打开目标网页的源代码,在代码里定位到承载所需内容的那一段标签。用Chrome的话,在网页上点右键选检查,就能比较直观地看到对应标签。
规则的基本写法里,@充当分隔符,把每一段获取规则隔开。第一段写类型,比如class、id、tag;children用于取出全部子标签,这种情况下第二段和第三段都可以省掉。第三段写位置,因为class和tag往往会命中多个元素,必须靠位置来定位,id类型则不需要再加位置。若省去位置,命中的就是全部结果。
!代表排除,遇到位置不合要求的情况就用!剔除,后面的序号用冒号隔开,%表示最后一个。@的最后一段决定取什么内容,text、textNodes、href、src、html等都可以填。同一份规则要应付不同网页时,可用竖线或&符号分隔,竖线以第一个取到值的规则为准,&则把所有规则取到的值合并起来。需要正则替换的话,在末尾追加#加正则表达式即可。
@text|@text#全文阅读,@text&@text#全文阅读,两条写法分别对应取先到值和合并取值两种情形。
1. 自定义书源:用户自己设定规则去抓取网页数据,规则本身不复杂,软件内附有写法说明。
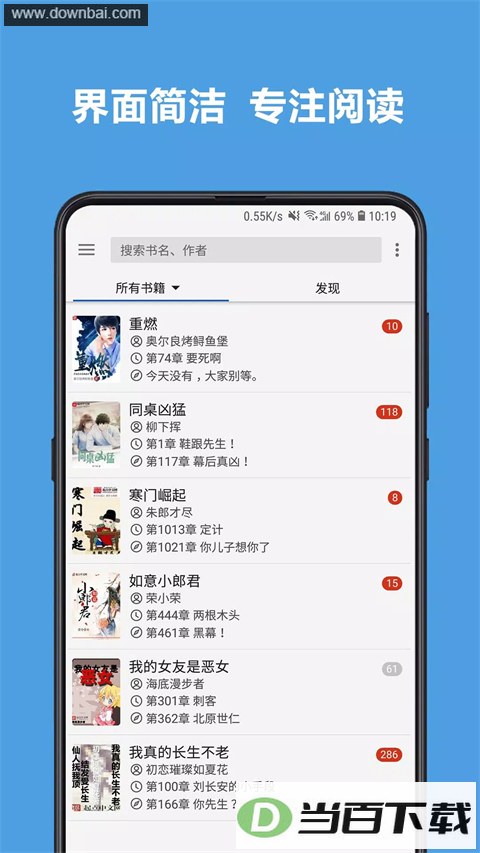
2. 书架视图:列表式与网格式两种排布可自由切换。
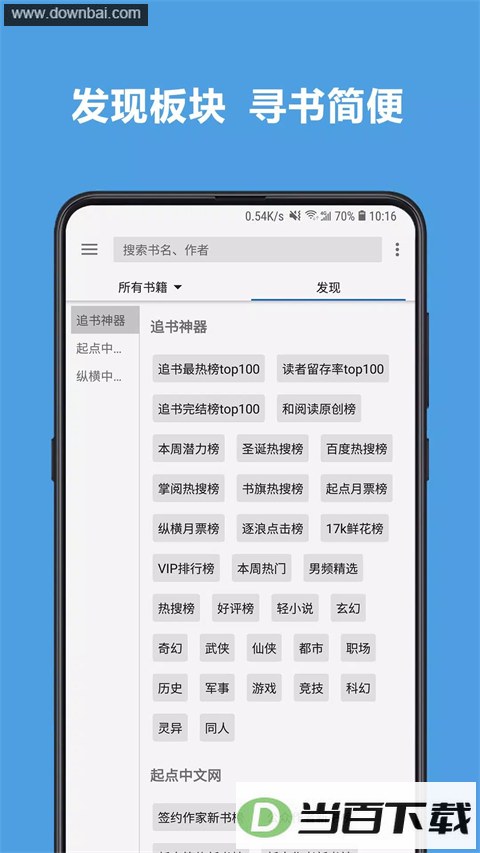
3. 搜索与发现:书源规则并且支撑搜索和发现,找书、看书相关功能全部由用户定义。
4. 替换净化:清除广告、替换正文内容都较为省事。
5. 本地阅读:可打开本地TXT、EPUB文件,支持手动浏览与智能扫描。
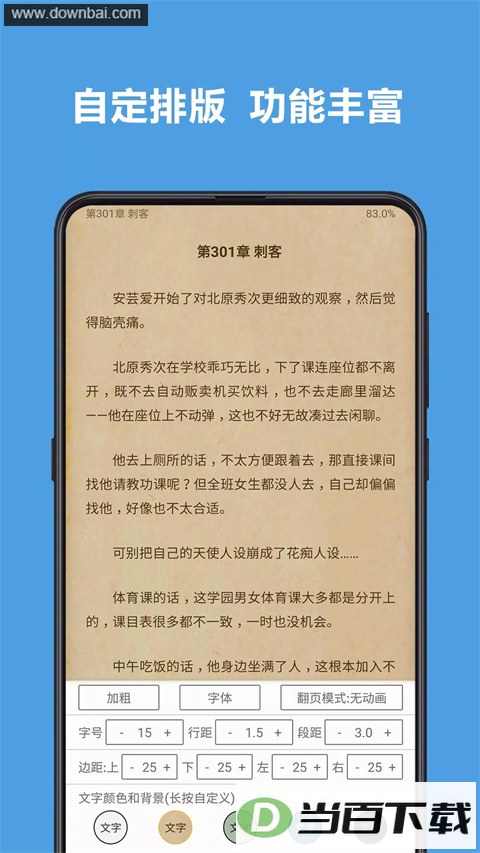
6. 阅读界面自定义:字体、颜色、背景、行距、段距、加粗、简繁转换等都能调。
7. 翻页模式:提供覆盖、仿真、滑动、滚动等多种方式。
8. 开源无广告:代码开放,后续仍在持续优化,使用过程中不插入广告。
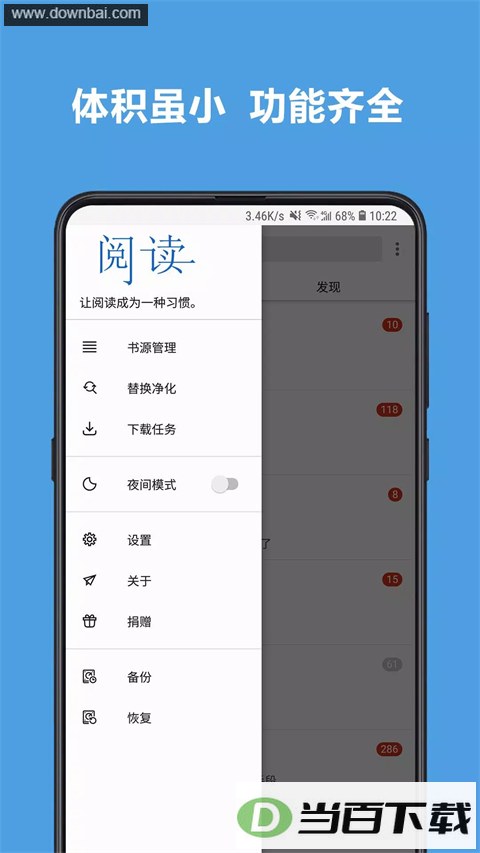
- 先把软件安装到手机并打开,在界面右下角找到我的按钮,点进去后选择书源管理。
- 进入书源管理页面,点右上角那个三圆点按钮,导入方式由用户自行挑选。
- 以本地导入为例,在文件列表里找到事先下载好的书源文件确认即可。若手上没有本地文件,也可以走网络导入,选中提供书源的网站完成导入。
应用截图




(您的评论需要经过审核才能显示)
0条评论