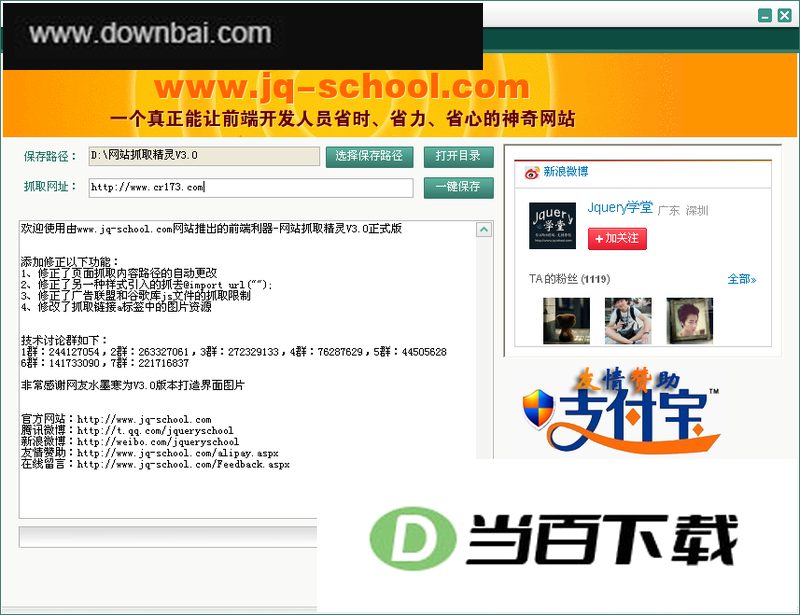
网站前端抓取利器,在它的帮助下你能够完整下载网站的内容,你下载到本地硬盘中的网站内容将仍保持原本的 HTML 格式,其文件名与目录结构都不会变化,这样可以准确地提供网站的镜像。网站抓取精灵特点: 1、一键保存页面文字 2、下载页面所有图片 3、保存页面所有css 4、保存页面js文件 5、下载单页所有相关文件 6、保存带参数的css和js文件 7、生成单个页面index.html 更新日志: 网站抓取精灵V3.0正式版 添加修正以下功能: 1、修正了页面抓取内容路径的自动更改 2、修正了另一种样式引入的抓去@import url( ); 3、修正了广告联盟和谷歌库js文件的抓取限制 4、修改了抓取链接a标签中的图片资源 网站抓取精灵v2.0更新内容 1、添加了工具运行加载界面 2、修正了一键保存页面内容、样式、图片、js文件,再进一步抓取样式文件里面的所有图片 3、修正了保存带参数的css和js文件 4、添加了打开目录功能 5、添加了生成单个页面index.html 温馨提示:txt说明文档不能删除!
本页提供的是 网站抓取精灵 v3.1.0.0 官方版本。下载后请认准官方安装包,安装时留意勾选项,避免附带安装不必要的组件;遇到杀毒软件拦截,按提示放行即可。老版本可直接覆盖安装,原有配置一般会保留。
1、 网站前端抓取利器,在它的帮助下你能够完整下载网站的内容,你下载到本地硬盘中的网站内容将仍保持原本的
2、 网站抓取精灵特点: 1、一键保存页面文字 2、下载页面所有图片 3、保存页面所有css 4、保存页面
- 安装时留意勾选项,避免附带安装不必要的附加组件。
- 建议从官方或可信渠道更新,保持版本最新。








(您的评论需要经过审核才能显示)
0条评论