VoiceStudio 是一个开源的语音工作台,把多套 TTS 合成引擎和 ASR 识别引擎集成在一起,用户能在这些引擎间一键切换,按实际场景挑出更合适的效果。想做零样本音色克隆,准备 3 到 15 秒的参考音频就能复刻出说话人的音色,语气和发声特征也能一并还原;也可以直接描述年龄、口音、情绪,让系统生成一个全新的人声。
VoiceStudio电脑版把音频转录、字幕生成、多人声区分、翻译以及配音这些环节串联成一条完整的工作流,视频本地化制作可以在同一款软件里从头做到尾,专业语音处理任务因此变得既省事又高效。
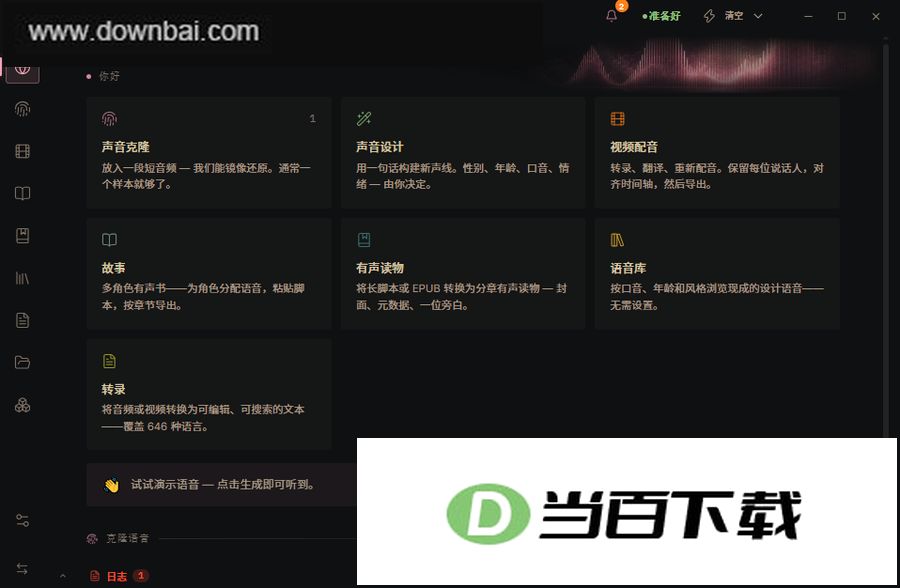
1、启动VoiceStudio电脑版后,切换到【语音】页面;
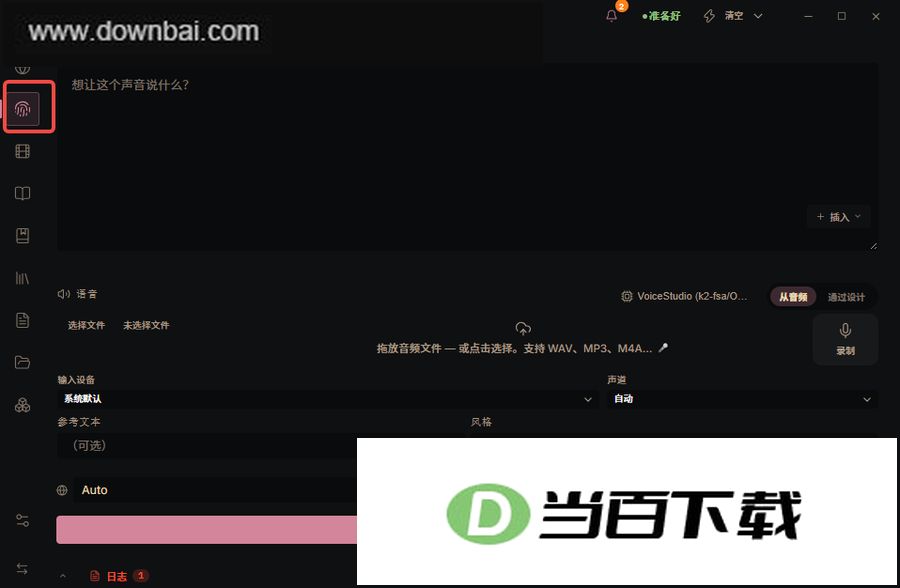
2、把希望声音朗读的内容填写到输入框里;
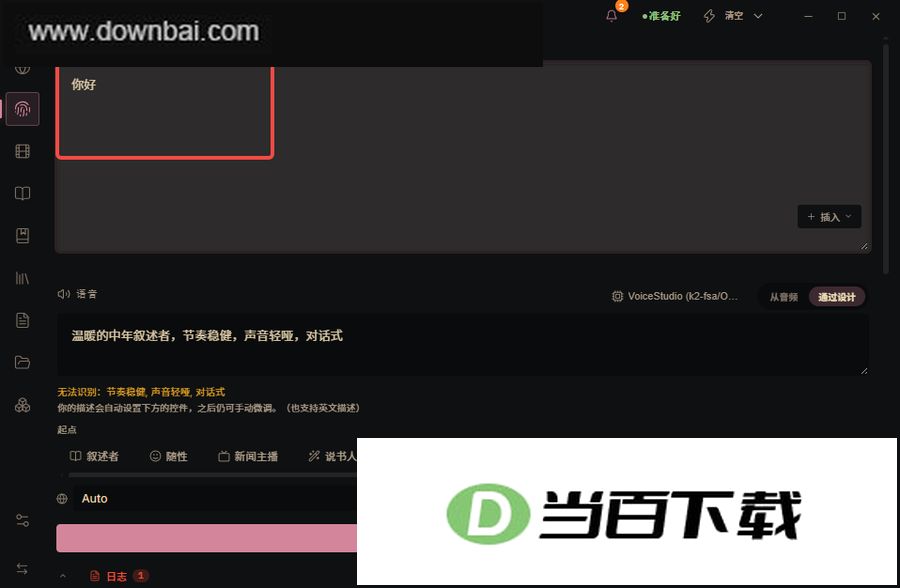
3、从预设方案中挑选一项,或者通过“描述你的声音”功能,把能听到的特征写清楚——比如年龄区间、声线特质、语速、口音、力度以及所适用的表达场景;
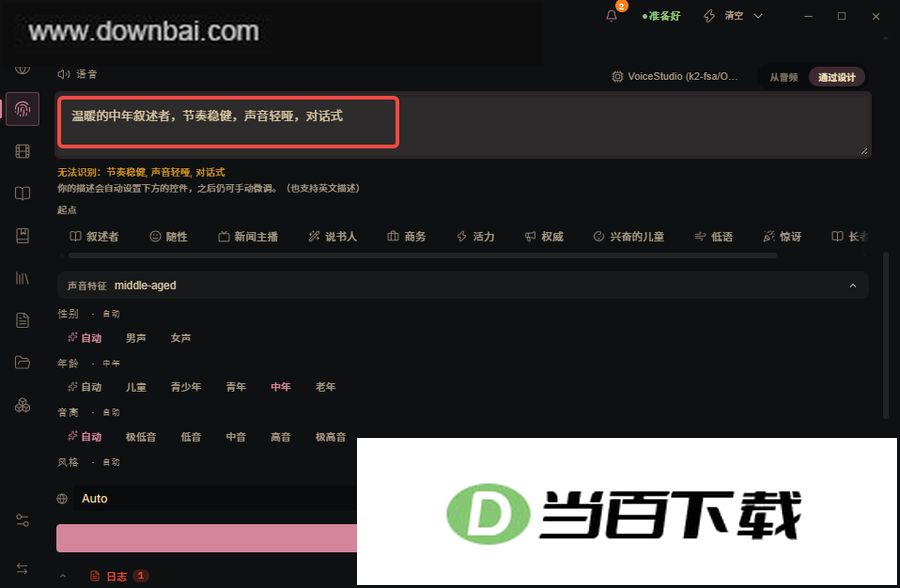
4、声音设置还可以再往下细调。
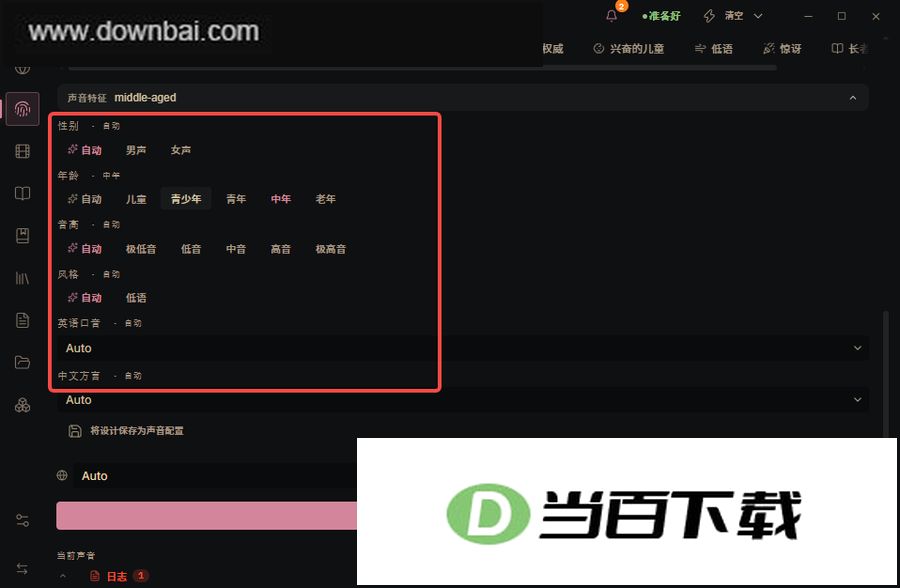
5、最后点选【生成音频】就可以了;
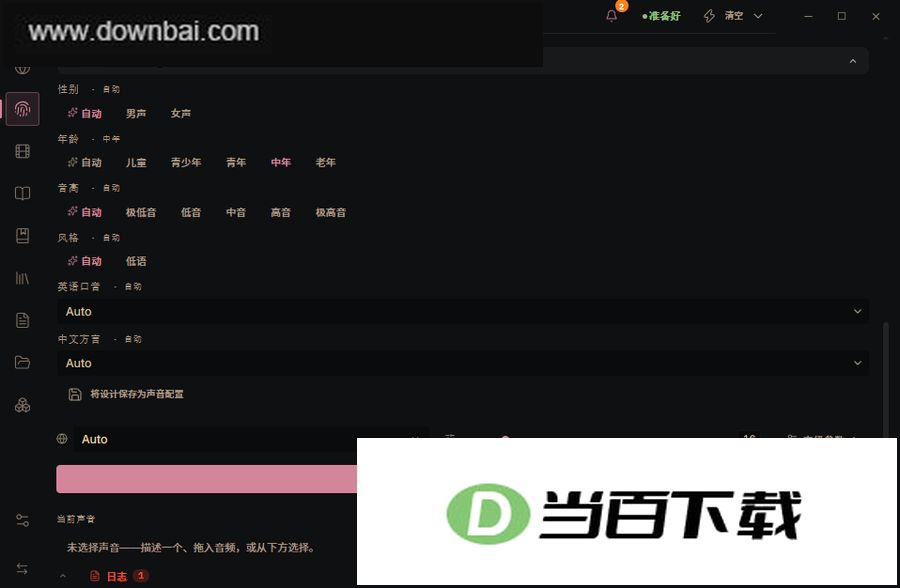
6、以上便是VoiceStudio电脑版创建新声音的完整操作指引。
v0.5.6版本
一、亮点
1、接到 Twilio 来电时,可用事先存好的语音向对方致意并完成接听;该功能初始为关闭状态,并附带本地通话质量检测。
2、VoiceStudio 现已打通 Claude Code、Cursor、Codex CLI 与 OpenAI Agents SDK,这些工具均已成功接入并可正常使用。
3、将已保存克隆的参考样本进行替换,再从 OmniVoice 里克隆时长超过 20 秒的参考音频
4、在 8 GB 显存的 GPU 上即可处理长篇有声书的章节,即使中途断电或数据文件夹被移动,也能正常应对。
5、马拉雅拉姆语数字与章节提示表,以及未带语音标记标签的字幕
二、已更改
Voice Clone 的活动引擎会依据参考音频的实际时长来运作,并不会强制你把素材压缩到 15 秒以内。
三、已添加
1、对已保存的语音克隆参考样本进行编辑:可先播放试听,再通过上传音频或直接录制的方式将其替换,最终保存回原有的同一语音条目。
2、通过已存语音应答 Twilio 来电:该功能初始为关闭状态,采用签名 Webhook 与一次性流令牌机制,并支持本地通话质量检测
3、在马拉雅拉姆语配音与有声读物中,数字、百分比及小数均以马拉雅拉姆语的口语形式呈现,而非直接照读原始数字。
4、故事或有声书渲染完毕后,可获取一份章节提示表(HH:MM:SSTitle),其时间戳与 M4B 内嵌章节一一对应,并附带 MP3 便携式章节信息
5、OpenAI Agents 集成页面给出了一段可直接复制的代码,把它放到 VoiceStudio 上就能运行 Agents SDK 的语音管道。
6、OpenAI 兼容 API 新增 GET /v1/models 与 POST /v1/audio/translations 两个接口,后者由多语言 Whisper 模型提供支持,并会拒绝 turbo 模型。
7、语音请求支持 stream_format(audio 或 sse)以及 OpenAI 的 {"id": ...} 语音对象
8、转录时由 language、prompt 和 temperature 三项参数共同传入 Whisper 引擎处理,返回结果中的 words 字段则通过 timestamp_granularities[]=word 指定获取。
9、集成能力:提供可复制的 Codex CLI(config.toml),支持任意 MCP 客户端(HTTP 或 stdio)接入,并可通过 VoiceStudio API(curl 与 OpenAI SDK)调用,同时支持 Docker/GHCR 部署方式。
四、已修复
1、字幕粘贴或导入后,卡拉OK标签将不再被识别;WebVTT与SubRip导出文件若未经改动,原始字幕标记仍会保留。
2、已保存声音并上传超过20秒音频后,可在OmniVoice上再次进行克隆,系统会自动选取最佳片段。
3、VoxCPM2 改变了以往的做法,不再把一段容量有限的参考素材与整段文本一一对应起来。
4、说话人分割功能采用 Lightning 2.6.6 版本,这一版本能够拦截来自恶意检查点的代码执行行为
5、在 8 GB 显存环境下,长篇有声书章节渲染时不会再出现超时;遇到超时的章节,会在当前分块处理完成后停止占用 GPU。
6、Windows 环境下重置连接后,后端不会再出现仍在运行却无法访问的状况。
7、官方 OpenAI SDK 与 OpenAI Agents SDK 维持原状:gpt-4o-mini-tts 以及现有的 OpenAI 语音名称不会再因为“未知模型”而报错失败
8、语音引擎如今会读取 OpenAI instructions 中的内容,而不再将其跳过;OmniVoice 正是借助其中的语音设计标签来实现这一处理。
9、语音 PCM 采样率为 24 kHz,这一点与 OpenAI 的规范一致;AAC 与 Opus 均返回真实的对应编码格式,若缺少编码器则属于明显错误,而非被错误标记的 WAV 文件
10、转录报告会显示实际检测到的语言,不再固定显示英语;verbose_json 的分段结构也与 OpenAI 的模式保持一致。
11、兼容 OpenAI 的路由在出错时按 OpenAI 格式返回,遇到无效请求则给出 400 响应
12、有声书章节渲染完成后,即便数据文件夹被移动,仍可继续使用;关机也不会清除恢复点或破坏章节音频。
13、音频书章节缓存未命中时,现在会记录自缓存渲染之后哪些输入发生了变化。
14、Docker 环境下的 MCP 客户端将 /mcp 作为连接目标,采用从源码构建的方式,而非直接拉取,从而避开 HTTP 405 问题
15、MCP 工具与 backend.speech_client 统一采用同一后端,端口通过 OMNIVOICE_PORT 获取,不再默认使用 3900。
16、卡片标注是否属实有明确判断:只有确实存在对应设置项时才会显示“支持 VoiceStudio”,其余情况一律标为“外部链接”。
1、声音克隆
放一段短视频,我们把它镜像翻转一下。一般三秒左右就行。
2、声音设计
用一句话就能生成全新的声音,性别、年龄、口音、音调与情感均可自由设定。
3、视频配音
转录、翻译并重新配音,保留每位说话人信息,同时完成时间对齐。
4、故事
多角色有声书:先挑选配音人选,再安排进脚本中。
5、有声书
可将篇幅较长的剧本或EPUB电子书转化为分章节呈现的有声书作品。
6、配音画廊
按口音、年龄与风格分类整理好的现有音色可供挑选试听。
7、文字记录
把音频或视频内容转成文字,转换后的文本支持编辑与检索。



(您的评论需要经过审核才能显示)
0条评论