仿站小工具是一款用于将整站静态资源抓取到本地的实用软件。用户只需输入目标网址,它就能自动下载网页的HTML代码,并从中解析出JS、CSS、图片、Flash等静态文件。软件会依据预设的保存规则,自动修正网页和CSS中的链接路径,让下载下来的文件按分类存放,方便本地浏览或二次开发。对于需要快速获取网页模板或素材的开发者来说,这款工具能节省不少手动保存的时间。
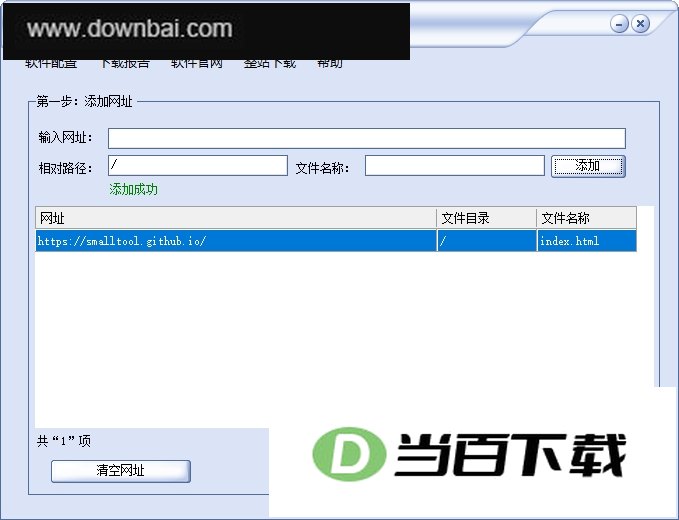
1、 从用户输入的网址开始,自动获取网页的HTML源代码
2、 解析HTML、提取出JS、CSS、Image、Picture、Flash等静态文件的直接链接
3、 再深入分析已下载的CSS文件,找出其中引用的背景图等图片资源并一并下载
4、 根据软件中设定的保存规则,自动改写HTML和CSS里的路径引用,确保本地打开时资源能正确加载
5、 所有文件最终按类型分类保存到用户指定的文件夹中,结构清晰
- 支持自动检测网页的编码格式,减少因编码不一致导致的乱码问题
- 可下载同域名或跨域名的CSS文件,并支持导入已有的CSS文件进行分析
- 能够从网页和CSS文件中识别出图片和背景图片,统一抓取到本地
- 文件保存路径可自定义,支持相对路径或绝对路径两种方式,适配不同使用场景
- 下载完成后,链接路径会自动修正,让离线浏览页面时样式和图片都能正常显示
- 乱码通常是因为HTTP响应头声明的编码与网页实际编码不一致。例如,HTTP头指定GB2312,但页面内容却是UTF-8,打开文件时浏览器按保存时的编码解析,导致乱码
- 解决方法一:用记事本打开乱码文件,点击“文件”菜单选择“另存为”,在编码下拉框中选与页面一致的编码(如UTF-8),覆盖保存即可
- 解决方法二:用记事本打开文件,找到HTML头部的编码声明标签(如<meta charset="...">),直接删除该标签,保存后浏览器会按文件实际编码自动识别
(您的评论需要经过审核才能显示)
0条评论